Jakauma
Off-topic warning
Tämä luku on kurssilla hieman nice-to-know -tyyppinen, eikä sen sisältöä hyödynnetä missään tehtävissä suoraan. Luku auttaa kuitenkin ymmärtämään, miksi muuttujille tehdään joskus epälineaarisia muunnoksia, kuten logaritminen tai Box–Cox-muunnos.
Samat käsitteet tulevat vastaan myös myöhemmissä aiheissa. Esimerkiksi logistisessa regressiossa todennäköisyyden ja mallin lineaarisen osan välillä käytetään epälineaarista yhteysfunktiota (engl. link function). Aikasarjoissa Box–Cox-muunnosta voidaan puolestaan käyttää esimerkiksi varianssin vakauttamiseen ennen muita stationaarisuuteen tähtääviä käsittelyvaiheita.
Kaikki muuttujan arvoihin kohdistuvat käsittelyt ovat eräänlaisia transformaatioita eli muunnoksia. Tämän materiaalin transformaatiot muokkaavat datan jakautumista (engl. distribution), toisin kuin skaalaukseen käytettävät menetelmät, kuten Z-score. Törmäät tähän kirjallisuuden esimerkeissä, joissa data on vinoutunutta (engl. skewed), ja datasta halutaan saada ulos selkeitä tilastollisia lukemia 1. Logaritminen muunnos linearisoi eksponentiaalisen trendin, ja oikessa tilanteessa käytettynä se voi parantaa mallin tulkittavuutta, optimointialgoritmin konvergenssin nopeutta tai mallin yksinkertaisuutta 2.
Datasetin yksittäisten muuttujien ei kuitenkaan ole pakko olla yksinään tarkasteltuina normaalijakaumaa noudattavia, jotta sitä voidaan käyttää koneoppimismallien kanssa. Feature-engine -kirjaston dokumentaatio vahvistaa, että lineaarinen regressio odottaa, että on olemassa lineaarinen riippuvuus (yhden tai useamman) selittävän ja selitettävän muuttujan välillä (eli x_i ja y välillä). 3 Jäännösvirheen tarkkailu voi siis käytännössä vihjata, josko lineaarinen malli hyötyisi alla mainituista muunnoksista. Epälineaariseen malliin, kuten puihin tai neuroverkkoihin, siirtyminen voi olla myös tällöin varteenotettava vaihtoehto 2.
Palkkadatan luomiskertomus
Generoidaan satunnaisesti dataa, joka edustaa normaalijakaumaa siten, että keskiarvo on 30 000 ja keskihajonta 10 000. Lisätään dataan noin 1 % ihmisiä, joiden keskipalkka on 150 000 ja keskihajonta 50 000. Tämä luo vinoutunutta dataa, jossa vinouma on positiivinen (eli kohti suurempia arvoja).
import numpy as np

# Generate 10k people's salaries
num_samples = 10_000

# Most people have average salaries
low_salaries = np.random.normal(
    loc=30_000,
    scale=10_000,
    size=num_samples
    )

# Some people have high salaries
high_salaries = np.random.normal(
    loc=150_000,
    scale=50_000,
    size=num_samples // 100
    )

# Concatenate the two arrays
salaries = np.concatenate((low_salaries, high_salaries))

# Remove round to nearest dollar
salaries = np.round(salaries, 0)

# Drop negative or zero salaries
salaries = salaries[salaries > 0]
Syntyvä data näyttää seuraavalta:
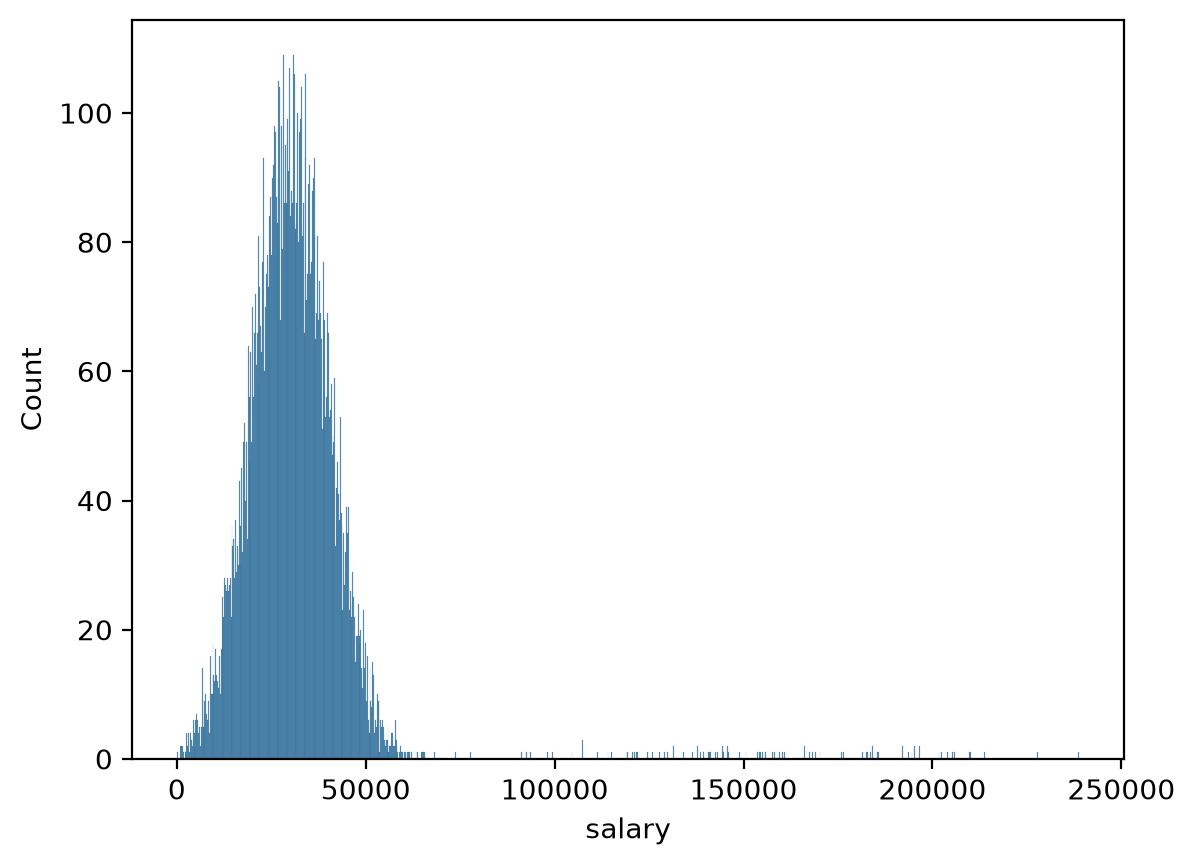
Kuva 1: Palkkadata, joka on vinoutunut kohti suuria arvoja.
Vinouma on positiivinen, mikä johtuu dataan tarkoituksella upotetuista suurista palkoista. Jos aivan tarkkoja ollaan datan syntytarinan suhteen, niin data on multi- tai bimodaalista, eli sillä on kaksi huippua. Lopputulemasta tätä on kuitenkin huomattavan vaikea sanoa, joten datan voidaan nyt tulkita olevan vinoutunutta seuraavia esimerkkejä varten.
Huomaa, että suurin osa palkoista sijaitsee välillä 0-60 000. Vasemmalla puolella data leikkautuu nollan kohdalla. Oikealla on hajanaisia suuria palkkoja. Suurin palkka tässä tasasetissä on 268 898.
Vinous (skew)
Vinous kuvaa datan jakautumista. Normaalijakautuneessa dataa vinous on nolla. Tosielämän datasetit poikkeavat usein normaalijakautuneesta datasta. Vinous voi olla positiivinen tai negatiivinen.
Vinouman laskemiseksi käytetään seuraavaa kaavaa:
def skew(x):
    n = len(x)
    mean = np.mean(x)

    nominator = 1/n * np.sum((x - mean) ** 3)
    denominator = (1/n * np.sum((x - mean) ** 2)) ** (3/2)

    return nominator / denominator
Huipukkuus (kurtosis)
Huippuus kuvaa jakauman muotoa. Huipukkuuden kaava on seuraava:
def kurtosis(x):
    n = len(x)
    mean = np.mean(x)

    nominator = 1/n * np.sum((x - mean) ** 4)
    denominator = (1/n * np.sum((x - mean) ** 2)) ** 2

    return (nominator / denominator) - 3
Laskuoperaatiot
Jos datasetistä lasketaan vinouma ja huipukkuus, saadaan seuraavat tulokset:
Vinouman korjaus
Vinoumaa voi pyrkiä korjaamaan useilla eri funktioilla. Idea on simppeli: aja kukin arvo jonkin funktion, kuten neliöjuuren, läpi. Alla on muutama keino esiteltynä, jotka toimivat nimenomaan silloin, kun data on positiivisesti vinoutunutta (eli kohti oikeaa). Jos data olisi negatiivisesti vinoutunutta, vinoumaa voisi korvata neliö tai kuutiofunktion avulla (salaries ** 2 tai salaries ** 3). 4
Log transformation
Logaritminen muunnos on yksinkertainen tapa. Kukin arvo asetetaan logaritmiin, jonka kantaluku (engl. base) on yleensä 10 tai e. Logaritmi palauttaa numeron, joka kuvaa, mihin potenssiin kantaluku on korotettava saadakseen alkuperäisen arvon. Lähellä nollaa olevat luvut pienenvät mitättömän vähän, suuret luvut paljon.
Korjaus on näinkin simppeli:
>>> log_salaries = np.log(salaries)
>>> skew(log_salaries)
-0.98
>>> kurtosis(log_salaries)
8.44
Juuri
Toinen yleinen muunnos on neliöjuuri tai kuutiojuuri (engl. square or cube root). Kuutiojuuri palauttaa luvun, joka pitäisi kertoa kolmesti itsensä kanssa saadakseen alkuperäisen arvon. Eli cbrt(8) = 2, koska \(2 * 2 * 2 = 8\). Neliöjuuri toimii samalla tavalla, mutta kantaluku on 2.
>>> cbrt_salaries = np.cbrt(salaries)
>>> skew(cube_salaries)
0.93
>>> kurtosis(cube_salaries)
9.16
Box-Cox
Box-Cox-muunnos on suosittu muutos. Se vaatii parametriksi lambda-arvon, mikä pitää tavalla tai toisella löytää. Jos parhaan tuloksen antava lambdan arvo on jokin muu kuin 0, Box-Cox muunnos on seuraava:
Jos parhaaksi arvoksi osoittautui 0, kaava on:
Eli Pythonissa:
Oikean lambdan löytäminen on haastavaa, joten käytetään tässä yhteydessä Scipyn boxcox-funktiota, joka etsii parhaan lambdan automaattisesti. Mikäli haluat kokeilla funktion toteuttamista itse, kannattanee aloittaa log likelihood -funktion toteutuksesta, johon löytyy osviittaa täältä: SciPy Docs: scipy.stats.boxcox_llf. Tämän kurssin puitteissa voimme tyytyä kokeilemaan valmista SciPy-funktiota, kuten alla:
>>> from scipy.stats import boxcox
>>> box_salaries, best_lambda = boxcox(salaries)
>>> skew(box_salaries)
0.19
>>> kurtosis(box_salaries)
6.90
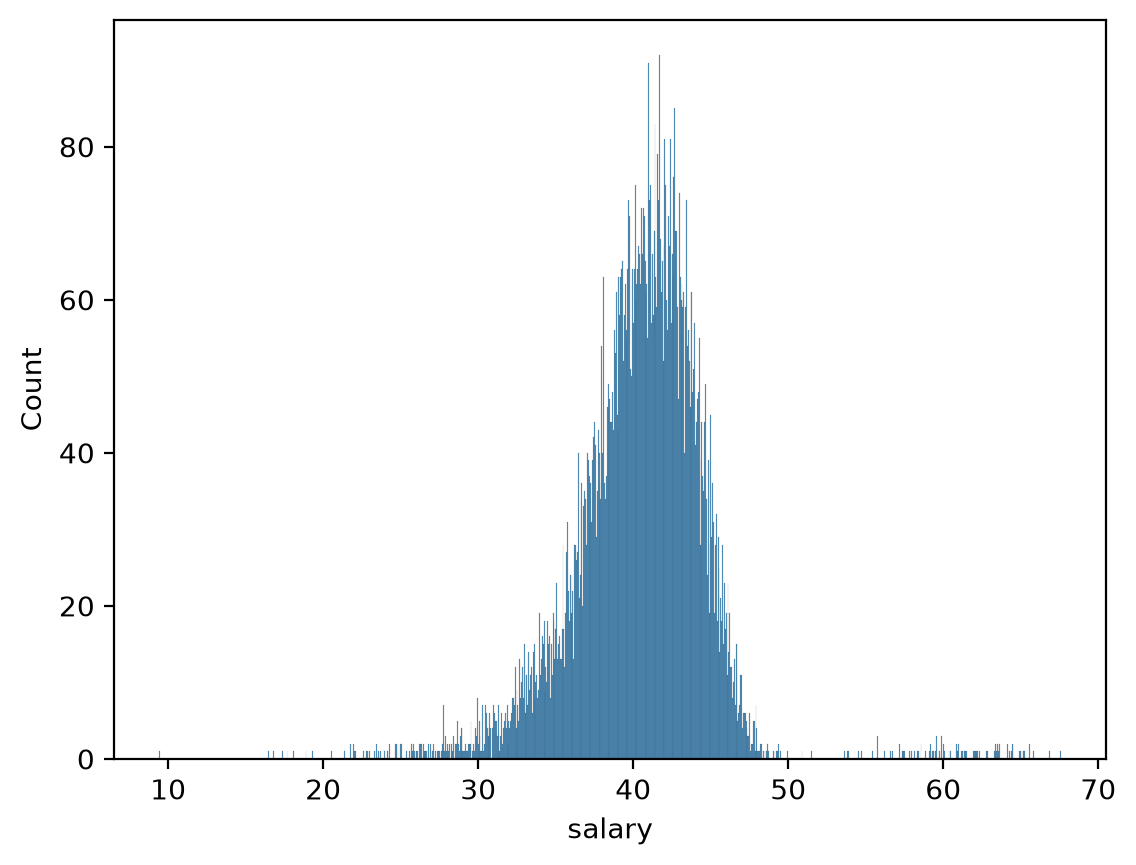
Kuva 2: Palkkadata muunnettuna Box-Cox-muunnoksella. Huomaa, että ongelma ei ole täysin hävinnyt, mutta loiventunut huomattavasti.
Muokattu datasetti voidaan palauttaa takaisin alkuperäiseen skaalaan käyttämällä scipy.special.inv_boxcox-funktiota.
from scipy.special import inv_boxcox

# Invert
inverted_salaries = inv_boxcox(boxcox_salaries, best_lambda)

# Compare to original (allowing floating point errors)
np.allclose(salaries, inverted_salaries)
Muut vaihtoehdot
Jatkuvan datan pakottaminen lähemmäs normaalia jakautumista voi parantaa mallin suorituskykyä. Muista kuitenkin, että on olemassa muitakin tapoja käsitellä vinoutunutta dataa.
Näitä ovat muiden muassa:
- Käytä mallia, joka ei ole herkkä vinoutuneelle data
- Ryhmittele data
- Pienituloiset, keskituloiset, suurituloiset, ...
- Tai käytä kvantiileja (alin 10 %, seuraava 10 %, ..., ylimmät 10 %)
- Poista outlierit kokonaan (riski!)
Lähteet
-
Massaron, L. & Boschetti, A. Regression Analysis with Python. Packt Publishing. 2016. ↩
-
Feature-engine developers. BoxCoxTransformer. https://feature-engine.trainindata.com/en/latest/user_guide/transformation/BoxCoxTransformer.html ↩
-
Gearheart, J. End-to-End Data Science with SAS. SAS Institute. 2020. ↩